Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Funktionsweise
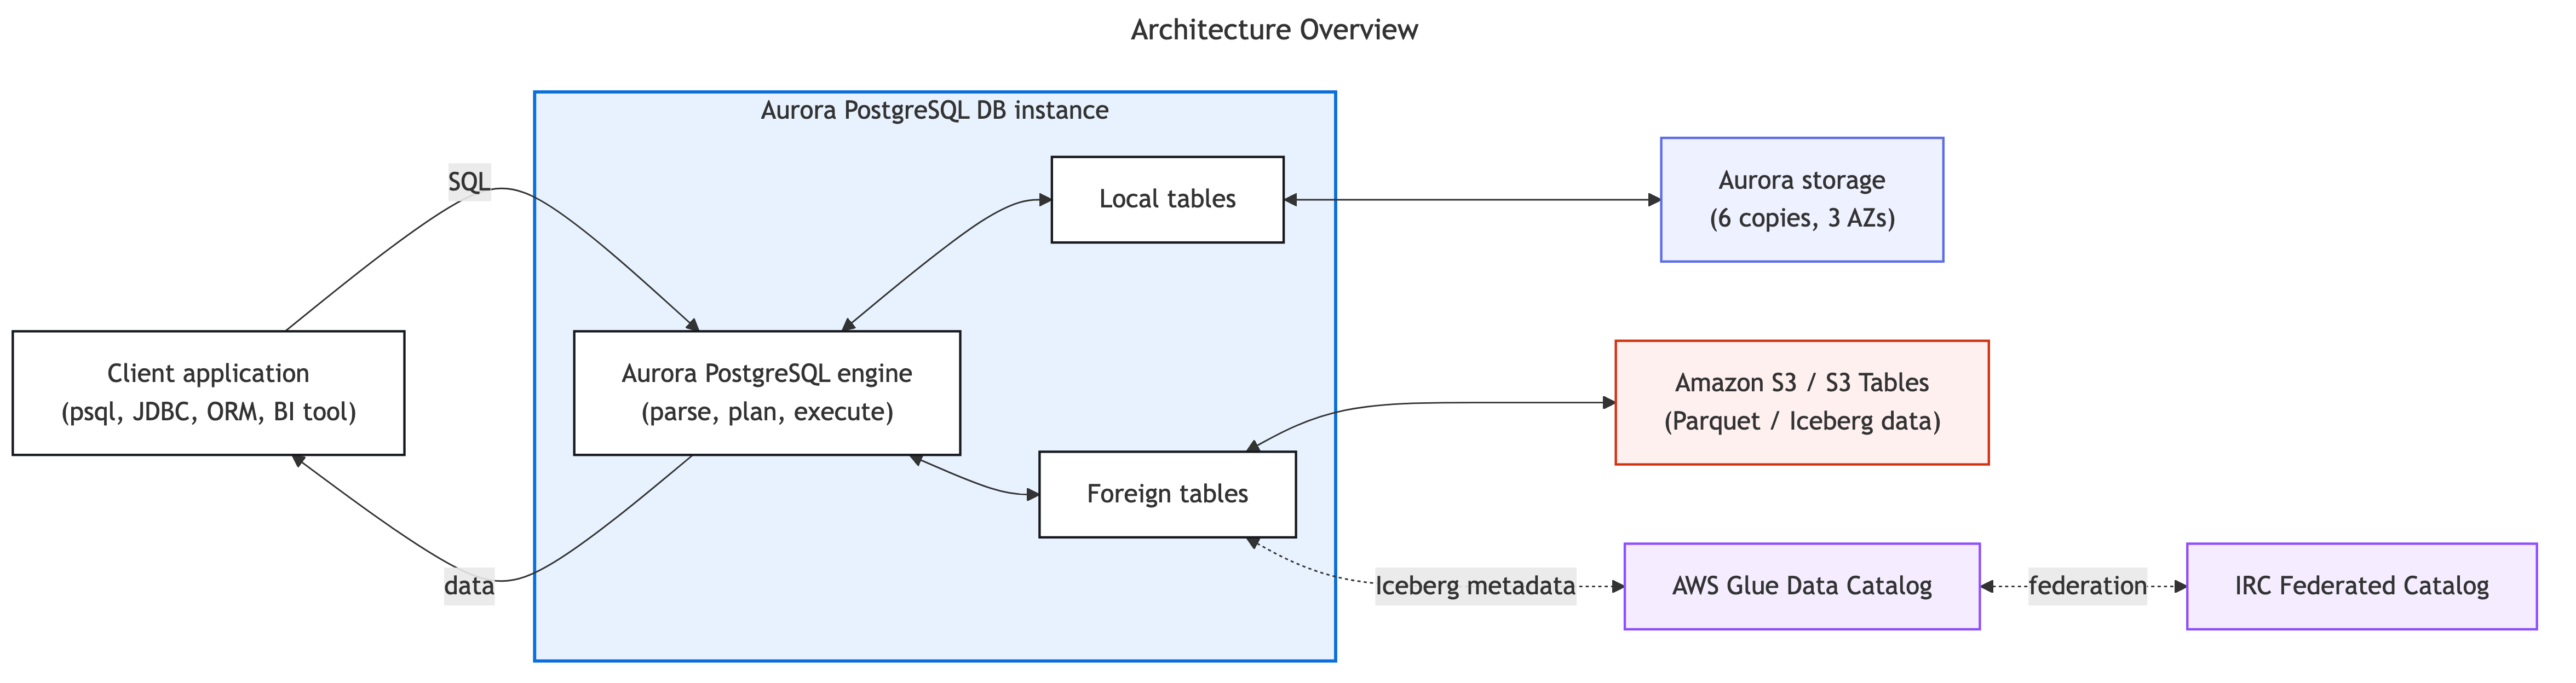
Aurora PostgreSQL führt Ihre analytischen Abfragen in Ihrem DB-Cluster aus und liest Iceberg- und Parquet-Daten direkt aus Amazon S3, ohne sie in Aurora zu verschieben oder ein separates System zu betreiben. Sie verweisen mit einer PostgreSQL-Fremdtabelle auf Ihre Daten in Amazon S3, Amazon S3-Tabellen oder dem AWS Glue Data Catalog und fragen sie dann mit Standard-SQL ab. In der Fremdtabelle werden nur Metadaten (Schema und Speicherort) gespeichert. Es werden keine Daten nach Aurora kopiert.
Wenn Ihre Anwendung eine Abfrage sendet, die auf eine Fremdtabelle verweist, analysiert und plant PostgreSQL die Abfrage und delegiert dann die Ausführung an DuckDB, die spaltenorientierte Open-Source-Analyse-Engine, die direkt in den PostgreSQL-Server eingebettet ist.
Bei Iceberg-Tabellen löst die Engine den entsprechenden Snapshot und seine Datendateien über die AWS Glue Data Catalog oder Amazon S3 S3-Tabellen auf. Mithilfe der Ihrem DB-Cluster zugewiesenen IAM-Rolle liest die Engine nur die Bytebereiche, die sie benötigt, aus Amazon S3- oder Amazon S3-Tabellen. Prädikats-Pushdown und Spaltenbereinigung überspringen Zeilengruppen und Spalten, auf die Ihre Abfrage nicht verweist. Daten, auf die häufig zugegriffen wird, werden im lokalen Speicher der DB-Instance zwischengespeichert und sitzungsübergreifend gemeinsam genutzt, sodass wiederholte Abfragen lokal bearbeitet werden können, anstatt erneut aus Amazon S3 zu lesen. Die Engine gibt Ergebnisse als Standard-PostgreSQL-Zeilen an Ihre Anwendung zurück.
Abfragen, die fremde Tabellen mit lokalen Aurora PostgreSQL-Tabellen verbinden, werden in einem einzigen Prozess ausgeführt und sehen die nicht festgeschriebenen Schreibvorgänge Ihrer Sitzung, die wie jede andere PostgreSQL-Abfrage an Ihren Transaktionen beteiligt sind. Ihr Treiber-, ORM- oder BI-Tool behandelt eine Fremdtabelle wie jede normale Aurora PostgreSQL-Tabelle.
Das folgende Diagramm zeigt einen Überblick über die Funktionen.
Die wichtigsten Konzepte
Die folgenden Konzepte sind von zentraler Bedeutung für die Abfrage von Iceberg- und Parquet-Daten in Aurora PostgreSQL.
-
Fremdtabellen: Von Ihnen definierte PostgreSQL-Tabellen, die auf Ihre Apache Parquet- oder Apache Iceberg-Daten in Amazon S3, Amazon S3 S3-Tabellen oder dem verweisen. AWS Glue Data Catalog Fremdtabellen verhalten sich wie normale PostgreSQL-Tabellen, aber die zugrunde liegenden Daten verbleiben in Ihrem Data Lake. Weitere Informationen finden Sie unter Mit fremden Tabellen arbeiten.
-
Analyse-Engine: Eine spaltenorientierte Analyse-Engine, die analytische Abfragen für Daten aus fremden Tabellen ausführt. Aurora PostgreSQL verwendet DuckDB, das direkt in den PostgreSQL-Server eingebettet ist. Da die Engine prozessbegleitend mit PostgreSQL läuft, muss nichts separat installiert oder verwaltet werden.
-
Abfragespeicher: Der Arbeitsspeicher, den die Analyse-Engine verwendet, um eine Abfrage auszuführen. Er wird durch den Parameter festgelegt.
aurora_analytics.query_memDie Standardeinstellung wird aus dem Speicher Ihrer Instanz abgeleitet. Weitere Informationen finden Sie unter Speicher abfragen. -
Worker-Threads: Die CPU-Parallelität, die die Engine verwendet, um eine Abfrage auszuführen. Aurora skaliert Worker-Threads automatisch anhand des Speicherbudgets der Abfrage. Weitere Informationen finden Sie unter Auftragnehmer-Threads.
-
Amazon S3 S3-Lesecache: Ein Cache mit häufig aufgerufenen Amazon S3 S3-Daten im lokalen Speicher der DB-Instance (NVMe oder Amazon EBS). Der Cache wird von allen Sitzungen auf der DB-Instance gemeinsam genutzt. Weitere Informationen finden Sie unter On-disk Cache lesen.
Die wichtigsten Funktionen
Die folgenden Funktionen werden unterstützt:
Datenzugriff und Formate
-
Fragen Sie Apache Parquet- und Apache Iceberg-Daten ab, die in Amazon S3, Amazon S3 S3-Tabellen und dem AWS Glue Data Catalog gespeichert sind. Verwenden Sie für Iceberg-Tabellen, die in externen Catalog-compatible Iceberg-REST-Katalogen verwaltet werden, den Verbund. AWS Glue Data Catalog
-
Referenzdaten mit Amazon S3 S3-URI, AWS Glue Data Catalog ARN oder Amazon S3 S3-Tabellen ARN. Bei AWS Glue Data Catalog Standorten wird das Datenformat automatisch anhand der Katalogmetadaten erkannt.
-
Wenn Sie eine Fremdtabelle mit einer leeren Spaltenliste erstellen, werden Spaltennamen und Datentypen automatisch aus den Parquet- oder Iceberg-Metadaten abgeleitet und Typen zugeordnet. PostgreSQL-compatible
-
Fragen Sie bei Iceberg-Tabellen den neuesten Snapshot, einen bestimmten Snapshot nach ID oder nach einem bestimmten Zeitstempel (Zeitreise) ab.
-
Fragen Sie Daten in einer anderen AWS Region ab als der, in der Ihr Aurora PostgreSQL-DB-Cluster bereitgestellt wird.
Ausführung und Optimierung von Abfragen
-
Prädikat-Pushdown und Spaltenbereinigung minimieren die aus Amazon S3 gelesenen Daten.
WHEREFilter werden beim Scan angewendet und verwenden Parquet- und Iceberg-Statistiken, um Zeilengruppen und Dateien zu überspringen, die nicht übereinstimmen können. Es werden nur die Spalten abgerufen, auf die Ihre Abfrage verweist. -
Ganze Abfragepläne, einschließlich Verknüpfungen zwischen Fremdtabellen und lokalen PostgreSQL-Tabellen, können für maximale Leistung an die Analyse-Engine übertragen werden.
-
Zu den unterstützten SQL-Funktionen gehören Aggregationen (
COUNT,SUM,AVG), Gruppieren und Filtern (GROUP BY,,ORDER BY)WHERE, Verknüpfungen zwischen Fremdtabellen und PostgreSQL-Tabellen, allgemeine Tabellenausdrücke (CTEs), vorbereitete Anweisungen (PREPARE/EXECUTE) und Abfrageplananalysen mit und.EXPLAINEXPLAIN ANALYZE -
Materialisieren Sie Abfrageergebnisse mit und in einer PostgreSQL-Tabelle oder materialisierten Ansicht.
CREATE TABLE AS SELECTCREATE MATERIALIZED VIEW AS SELECT -
Wenn eine Abfrage ihr Speicherbudget überschreitet, werden Zwischenergebnisse automatisch in den lokalen Speicher übertragen, sodass die Abfrage abgeschlossen wird.
Überwachen
-
Überwachen Sie analytische Workloads und beheben Sie Fehler mit denselben Tools, die Sie für Aurora PostgreSQL verwenden. Amazon CloudWatch meldet Cache-Trefferraten auf Instance-Ebene, Speichernutzung, verschüttete Festplatten und Amazon S3 S3-Aktivitäten.
-
EXPLAINundEXPLAIN ANALYZEzeigt zusammen mit Filter-Pushdown und Spaltenprojektion, welche Teile einer Abfrage in der Analytics-Engine ausgeführt werden. SQL-Funktionen melden Metriken pro Abfrage und für die gesamte Instanz wie Cache-Treffer, aus Amazon S3 gelesene Byte und auf die Festplatte verschüttete Byte. -
Die in der Analytics-Engine verbrachte Zeit wird im Rahmen des Wait-Events gemeldet.
Extension:AuroraAnalyticsExecuteAnalytische Abfragen werden im Diagramm der durchschnittlichen aktiven Sitzungen (AAS) in Amazon CloudWatch Database Insights und Performance Insights zusammen mit dem Rest Ihrer PostgreSQL-Arbeitslast angezeigt.
Kompatibilität
-
Koexistiert mit anderen Aurora PostgreSQL-Erweiterungen in derselben Datenbank und funktioniert mit Standard-PostgreSQL-Client-Tools und -Dienstprogrammen.
