Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
System zur Gesundheitsüberwachung
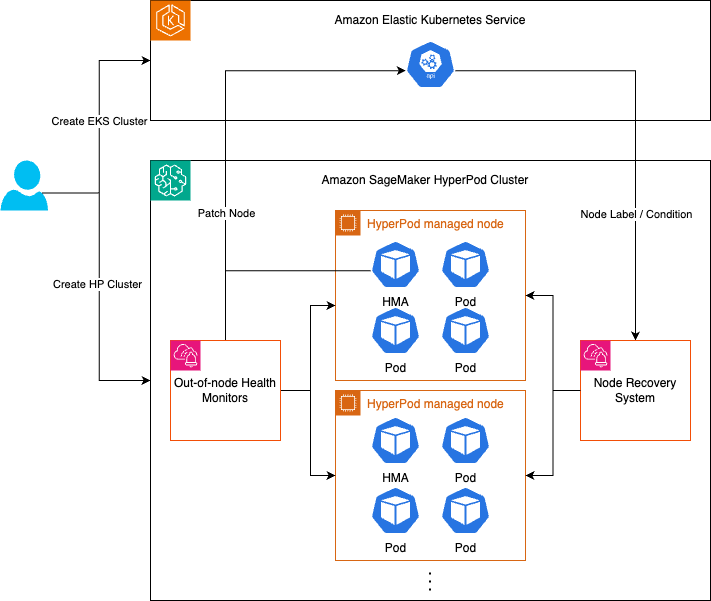
SageMaker HyperPod Das System zur Gesundheitsüberwachung besteht aus zwei Komponenten
-
Auf Ihren Knoten installierte Überwachungsagenten, zu denen der Health Monitoring Agent (HMA) gehört, der als Integritätsmonitor auf dem Host dient, und eine Reihe von Zustandsüberwachungen außerhalb des Knotens.
-
Node Recovery System, verwaltet von. SageMaker HyperPod Das Zustandsüberwachungssystem überwacht den Zustand des Knotens kontinuierlich mithilfe von Überwachungsagenten und ergreift dann mithilfe des Node Recovery Systems automatisch Maßnahmen, wenn ein Fehler erkannt wird.
Gesundheitschecks, die vom SageMaker HyperPod Gesundheitsüberwacher durchgeführt werden
Die für die SageMaker HyperPod Gesundheitsüberwachung zuständige Stelle überprüft Folgendes.
NVIDIA-GPUs
-
Fehler in der Ausgabe
nvidia-smi -
Verschiedene Fehler in den Protokollen, die von der Amazon Elastic Compute Cloud (EC2) -Plattform generiert wurden
-
Überprüfung der GPU-Anzahl — Wenn die erwartete Anzahl von GPUs in einem bestimmten Instance-Typ (zum Beispiel: 8 GPUs im Instance-Typ ml.p5.48xlarge) und der Anzahl, die von zurückgegeben wird, nicht übereinstimmt, dann startet HMA den Knoten neu
nvidia-smi
AWS Trainium
-
Fehler in der Ausgabe des AWS Neuron-Monitors
-
Vom Neuronknotenproblemdetektor generierte Ausgaben (Weitere Informationen zum AWS Neuronknotenproblemdetektor finden Sie unter Erkennung und Wiederherstellung von Knotenproblemen für AWS Neuronknoten in Amazon EKS-Clustern.)
-
Verschiedene Fehler in den von der Amazon EC2-Plattform generierten Protokollen
-
Überprüfung der Anzahl der Neuron-Geräte — Wenn die tatsächliche Anzahl der Neuron-Geräte in einem bestimmten Instanztyp nicht mit der Anzahl der zurückgegebenen
neuron-lsNeuron-Geräte übereinstimmt, startet HMA den Knoten neu
Die oben genannten Überprüfungen sind passiv. Die Zustandsprüfungen im Hintergrund werden kontinuierlich auf Ihren Knoten HyperPod ausgeführt. Zusätzlich zu diesen Prüfungen werden während der Erstellung und Aktualisierung von HyperPod Clustern HyperPod auch tiefgreifende (oder aktive) Integritätsprüfungen durchgeführt. Erfahren Sie mehr über Deep Health Checks.
Erkennung von Störungen
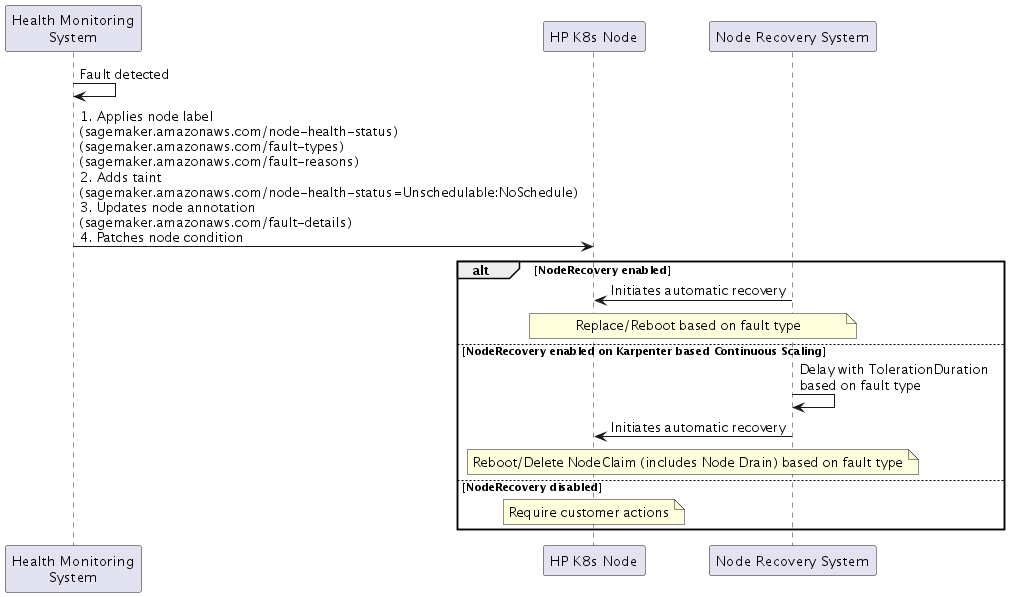
Wenn ein Fehler SageMaker HyperPod erkannt wird, implementiert es eine vierteilige Antwort:
-
Knotenbezeichnungen
-
Gesundheitszustand:
sagemaker.amazonaws.com/node-health-status -
Fehlertyp:
sagemaker.amazonaws.com/fault-typesBezeichnung für die Kategorisierung auf hoher Ebene -
Fehlergrund:
sagemaker.amazonaws.com/fault-reasonsEtikett mit detaillierten Fehlerinformationen
-
-
Node Taint
-
sagemaker.amazonaws.com/node-health-status=Unschedulable:NoSchedule
-
-
Anmerkung zum Knoten
-
Einzelheiten des Fehlers:
sagemaker.amazonaws.com/fault-details -
Zeichnet bis zu 20 Fehler mit Zeitstempeln auf, die auf dem Knoten aufgetreten sind
-
-
Knotenbedingungen (Kubernetes-Knotenzustand)
-
Spiegelt den aktuellen Gesundheitszustand in Bezug auf die Knotenbedingungen wider:
-
Typ: Entspricht dem Fehlertyp
-
Status:
True -
Grund: Entspricht dem Grund des Fehlers
-
LastTransitionTime: Zeitpunkt des Auftretens des Fehlers
-
-
Vom SageMaker HyperPod Gesundheitsüberwachungsagenten generierte Protokolle
Der SageMaker HyperPod Health Monitoring Agent ist eine sofort einsatzbereite Funktion zur Integritätsprüfung und wird kontinuierlich auf allen Clustern ausgeführt. HyperPod Der Health Monitoring Agent veröffentlicht erkannte Integritätsereignisse auf GPU- oder Trn-Instances in der Cluster-Protokollgruppe CloudWatch . /aws/sagemaker/Clusters/
Die Erkennungsprotokolle des HyperPod Health Monitoring Agents werden als separate Protokollstreams erstellt, die SagemakerHealthMonitoringAgent für jeden Knoten benannt sind. Sie können die Erkennungsprotokolle mithilfe von CloudWatch Log Insights wie folgt abfragen.
fields @timestamp, @message
| filter @message like /HealthMonitoringAgentDetectionEvent/
Dies sollte eine Ausgabe ähnlich der folgenden erzeugen.
2024-08-21T11:35:35.532-07:00
    {"level":"info","ts":"2024-08-21T18:35:35Z","msg":"NPD caught event: %v","details: ":{"severity":"warn","timestamp":"2024-08-22T20:59:29Z","reason":"XidHardwareFailure","message":"Node condition NvidiaErrorReboot is now: True, reason: XidHardwareFailure, message: \"NVRM: Xid (PCI:0000:b9:00): 71, pid=<unknown>, name=<unknown>, NVLink: fatal error detected on link 6(0x10000, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0)\""},"HealthMonitoringAgentDetectionEvent":"HealthEvent"}
2024-08-21T11:35:35.532-07:00
    {"level":"info","ts":"2024-08-21T18:35:35Z","msg":"NPD caught event: %v","details: ":{"severity":"warn","timestamp":"2024-08-22T20:59:29Z","reason":"XidHardwareFailure","message":"Node condition NvidiaErrorReboot is now: True, reason: XidHardwareFailure, message: \"NVRM: Xid (PCI:0000:b9:00): 71, pid=<unknown>, name=<unknown>, NVLink: fatal error detected on link 6(0x10000, 0x0, 0x0, 0x0, 0x0, 0x0, 0x0)\""},"HealthMonitoringAgentDetectionEvent":"HealthEvent"}
