Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Basis-Lifecycle-Skripts bereitgestellt von HyperPod
Dieser Abschnitt führt dich von oben nach unten durch alle Bestandteile des grundlegenden Ablaufs der Einrichtung von Slurm. HyperPod Es beginnt mit der Vorbereitung einer HyperPod Cluster-Erstellungsanforderung zur Ausführung der CreateCluster API und taucht tief in die hierarchische Struktur bis hin zu Lifecycle-Skripten ein. Verwenden Sie die Beispielskripte für den Lebenszyklus, die im Awsome Distributed Training GitHub Repository bereitgestellt werden.
git clone https://github.com/aws-samples/awsome-distributed-training/
Die grundlegenden Lifecycle-Skripte für die Einrichtung eines Slurm-Clusters SageMaker HyperPod finden Sie unter. 1.architectures/5.sagemaker_hyperpods/LifecycleScripts/base-config
cd awsome-distributed-training/1.architectures/5.sagemaker_hyperpods/LifecycleScripts/base-config
Das folgende Flussdiagramm zeigt eine detaillierte Übersicht darüber, wie Sie die Basis-Lebenszyklusskripte gestalten sollten. Die Beschreibungen unter dem Diagramm und dem Verfahrenshandbuch erklären, wie sie während des HyperPod CreateCluster API-Aufrufs funktionieren.
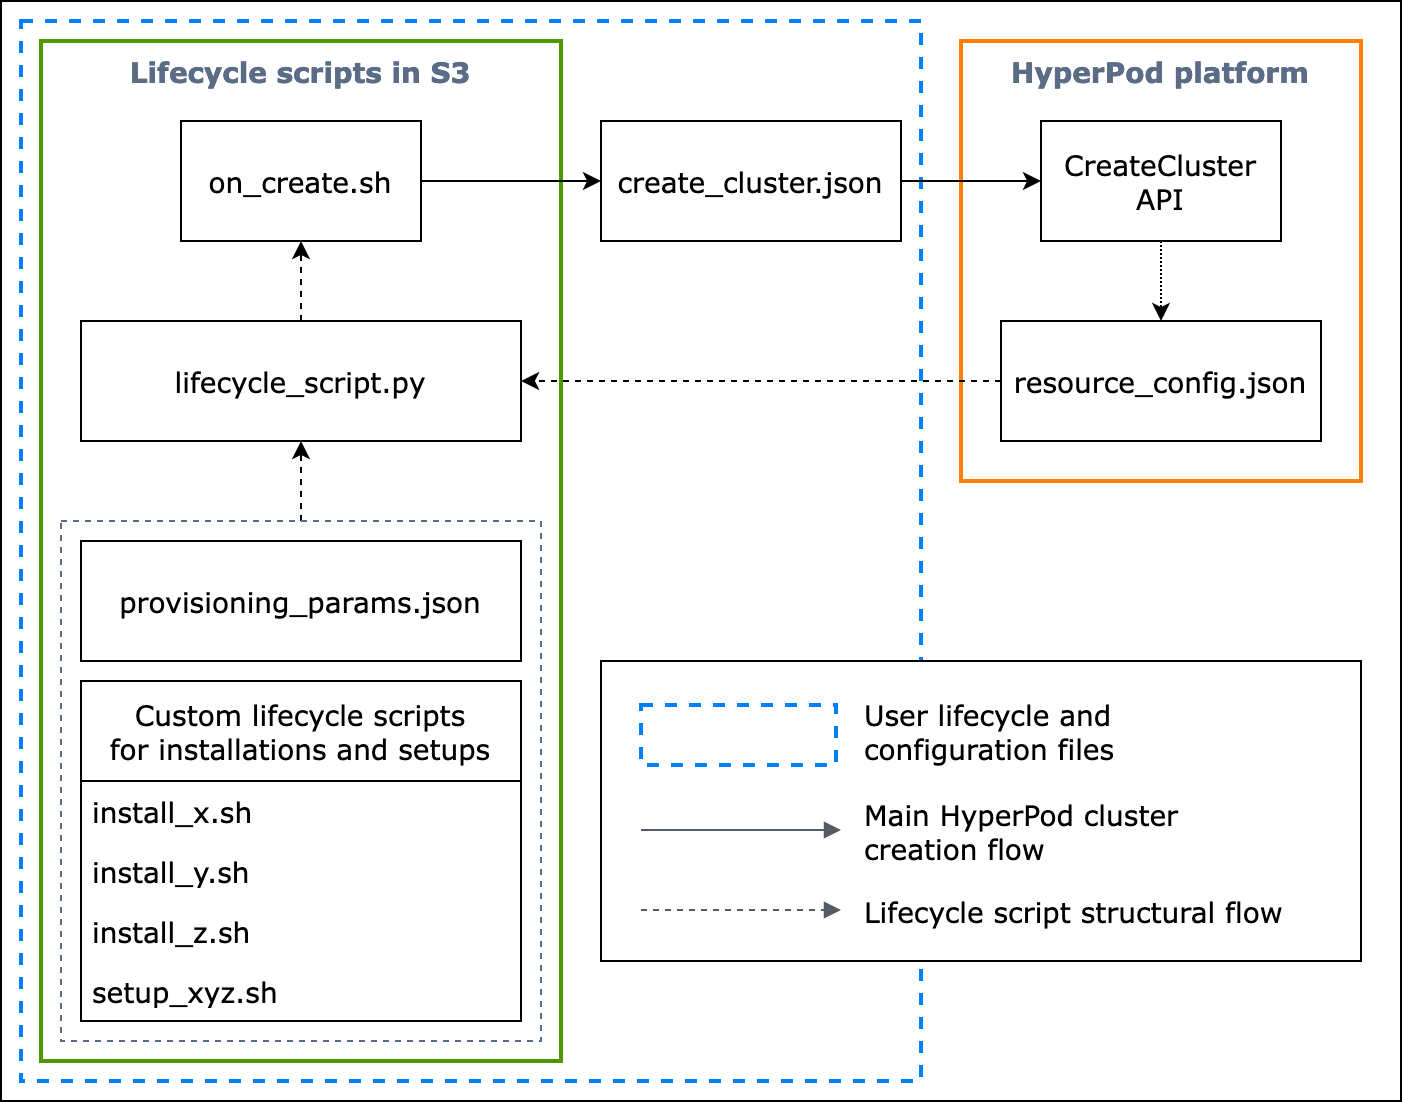
Abbildung: Ein detailliertes Flussdiagramm der HyperPod Clustererstellung und der Struktur von Lifecycle-Skripten. (1) Die gestrichelten Pfeile zeigen in die Richtung, in die die Kästen „aufgerufen“ werden, und veranschaulichen den Ablauf der Vorbereitung von Konfigurationsdateien und Lebenszyklusskripten. Der erste Schritt besteht in der Vorbereitung von provisioning_parameters.json und den Lebenszyklusskripten. Diese werden dann für eine gemeinsame Ausführung in der richtigen Reihenfolge in lifecycle_script.py codiert. Und die Ausführung des lifecycle_script.py Skripts erfolgt durch das on_create.sh Shell-Skript, das im HyperPod Instanz-Terminal ausgeführt werden soll. (2) Die durchgezogenen Pfeile zeigen den wichtigsten Ablauf der HyperPod Cluster-Erstellung und wie die Felder „aufgerufen“ oder „eingereicht an“ werden. on_create.shist für die Anfrage zur Clustererstellung erforderlich, entweder im Formular create_cluster.json oder im Formular „Anfrage zum Erstellen eines Clusters“ auf der Benutzeroberfläche der Konsole. Nachdem Sie die Anfrage eingereicht haben, HyperPod führt die CreateCluster API auf der Grundlage der angegebenen Konfigurationsinformationen aus der Anfrage und den Lifecycle-Skripten aus. (3) Der gepunktete Pfeil zeigt an, dass die HyperPod Plattform während der Bereitstellung von Clusterressourcen resource_config.json in den Clusterinstanzen erstellt. resource_config.jsonenthält HyperPod Cluster-Ressourceninformationen wie Cluster-ARN, Instanztypen und IP-Adressen. Es ist wichtig zu beachten, dass Sie die Lebenszyklusskripte so vorbereiten sollten, dass sie die resource_config.json-Datei während der Clustererstellung erwarten. Weitere Informationen finden Sie in der folgenden Verfahrensanleitung.
Im folgenden Verfahrenshandbuch wird erläutert, was bei der HyperPod Clustererstellung passiert und wie die grundlegenden Lebenszyklusskripts entworfen werden.
-
create_cluster.json— Um eine Anfrage zur HyperPod Clustererstellung einzureichen, bereiten Sie eineCreateClusterAnforderungsdatei im JSON-Format vor. In diesem Beispiel für bewährte Methoden gehen wir davon aus, dass die Anforderungsdateicreate_cluster.jsonheißt. Schreiben Siecreate_cluster.json, um einen HyperPod Cluster mit Instanzgruppen bereitzustellen. Am besten fügen Sie dieselbe Anzahl von Instanzgruppen hinzu wie die Anzahl der Slurm-Knoten, die Sie auf dem HyperPod Cluster konfigurieren möchten. Stellen Sie sicher, dass Sie den Instance-Gruppen, die Sie den Slurm-Knoten zuweisen möchten, eindeutige Namen geben.Außerdem müssen Sie einen S3-Bucket-Pfad angeben, um Ihren gesamten Satz an Konfigurationsdateien und Lebenszyklusskripten im Feldnamen
InstanceGroups.LifeCycleConfig.SourceS3UriimCreateCluster-Anforderungsformular zu speichern, und den Dateinamen eines Einstiegspunkt-Shell-Skripts (angenommen, es heißton_create.sh) alsInstanceGroups.LifeCycleConfig.OnCreateangeben.Anmerkung
Wenn Sie das Formular zum Einreichen eines Clusters in der Benutzeroberfläche der HyperPod Konsole verwenden, verwaltet die Konsole das Ausfüllen und Senden der
CreateClusterAnfrage in Ihrem Namen und führt dieCreateClusterAPI im Backend aus. In diesem Fall müssen Siecreate_cluster.jsonnicht erstellen. Achten Sie stattdessen darauf, dass Sie die richtigen Informationen zur Cluster-Konfiguration in das zu übermittelnde Formular Cluster erstellen eingeben. -
on_create.sh— Für jede Instanzgruppe müssen Sie ein Entrypoint-Shell-Skript bereitstellen, um Befehle auszuführenon_create.sh, Skripte zur Installation von Softwarepaketen auszuführen und die HyperPod Cluster-Umgebung mit Slurm einzurichten. Die beiden Dinge, die Sie vorbereiten müssen, sind eineprovisioning_parameters.jsonVoraussetzung HyperPod für die Einrichtung von Slurm und eine Reihe von Lifecycle-Skripten für die Installation von Softwarepaketen. Dieses Skript sollte so geschrieben werden, dass es die folgenden Dateien findet und ausführt, wie im Beispielskript unteron_create.shgezeigt. Anmerkung
Stellen Sie sicher, dass Sie den gesamten Satz von Lebenszyklusskripten an den in den S3-Speicherort hochladen, den Sie in
create_cluster.jsonangeben. Sie sollten Ihreprovisioning_parameters.jsonauch an demselben Speicherort speichern.-
provisioning_parameters.json— Das ist einKonfigurationsformular für provisioning_parameters.json. Dason_create.sh-Skript findet diese JSON-Datei und definiert eine Umgebungsvariable, um den Pfad zu ihr zu identifizieren. Über diese JSON-Datei können Sie Slurm-Knoten und Speicheroptionen wie Amazon FSx für Lustre für Slurm konfigurieren, mit denen Slurm kommunizieren soll. Stellen Sie sicherprovisioning_parameters.json, dass Sie die HyperPod Cluster-Instanzgruppen unter Verwendung der von Ihnen angegebenen Namencreate_cluster.jsonden Slurm-Knoten entsprechend der Art und Weise zuweisen, wie Sie sie einrichten möchten.Das folgende Diagramm zeigt ein Beispiel dafür, wie die beiden JSON-Konfigurationsdateien
create_cluster.jsongeschrieben werdenprovisioning_parameters.jsonsollten, um den HyperPod Slurm-Knoten Instanzgruppen zuzuweisen. In diesem Beispiel gehen wir von der Einrichtung von drei Slurm-Knoten aus: Controller-Knoten (Verwaltung), Anmeldeknoten (optional) und Rechenknoten (Worker).Tipp
Um Ihnen bei der Validierung dieser beiden JSON-Dateien zu helfen, stellt das HyperPod Serviceteam ein Validierungsskript zur Verfügung.
validate-config.pyWeitere Informationen hierzu finden Sie unter Validierung der JSON-Konfigurationsdateien vor dem Erstellen eines Slurm-Clusters auf HyperPod. 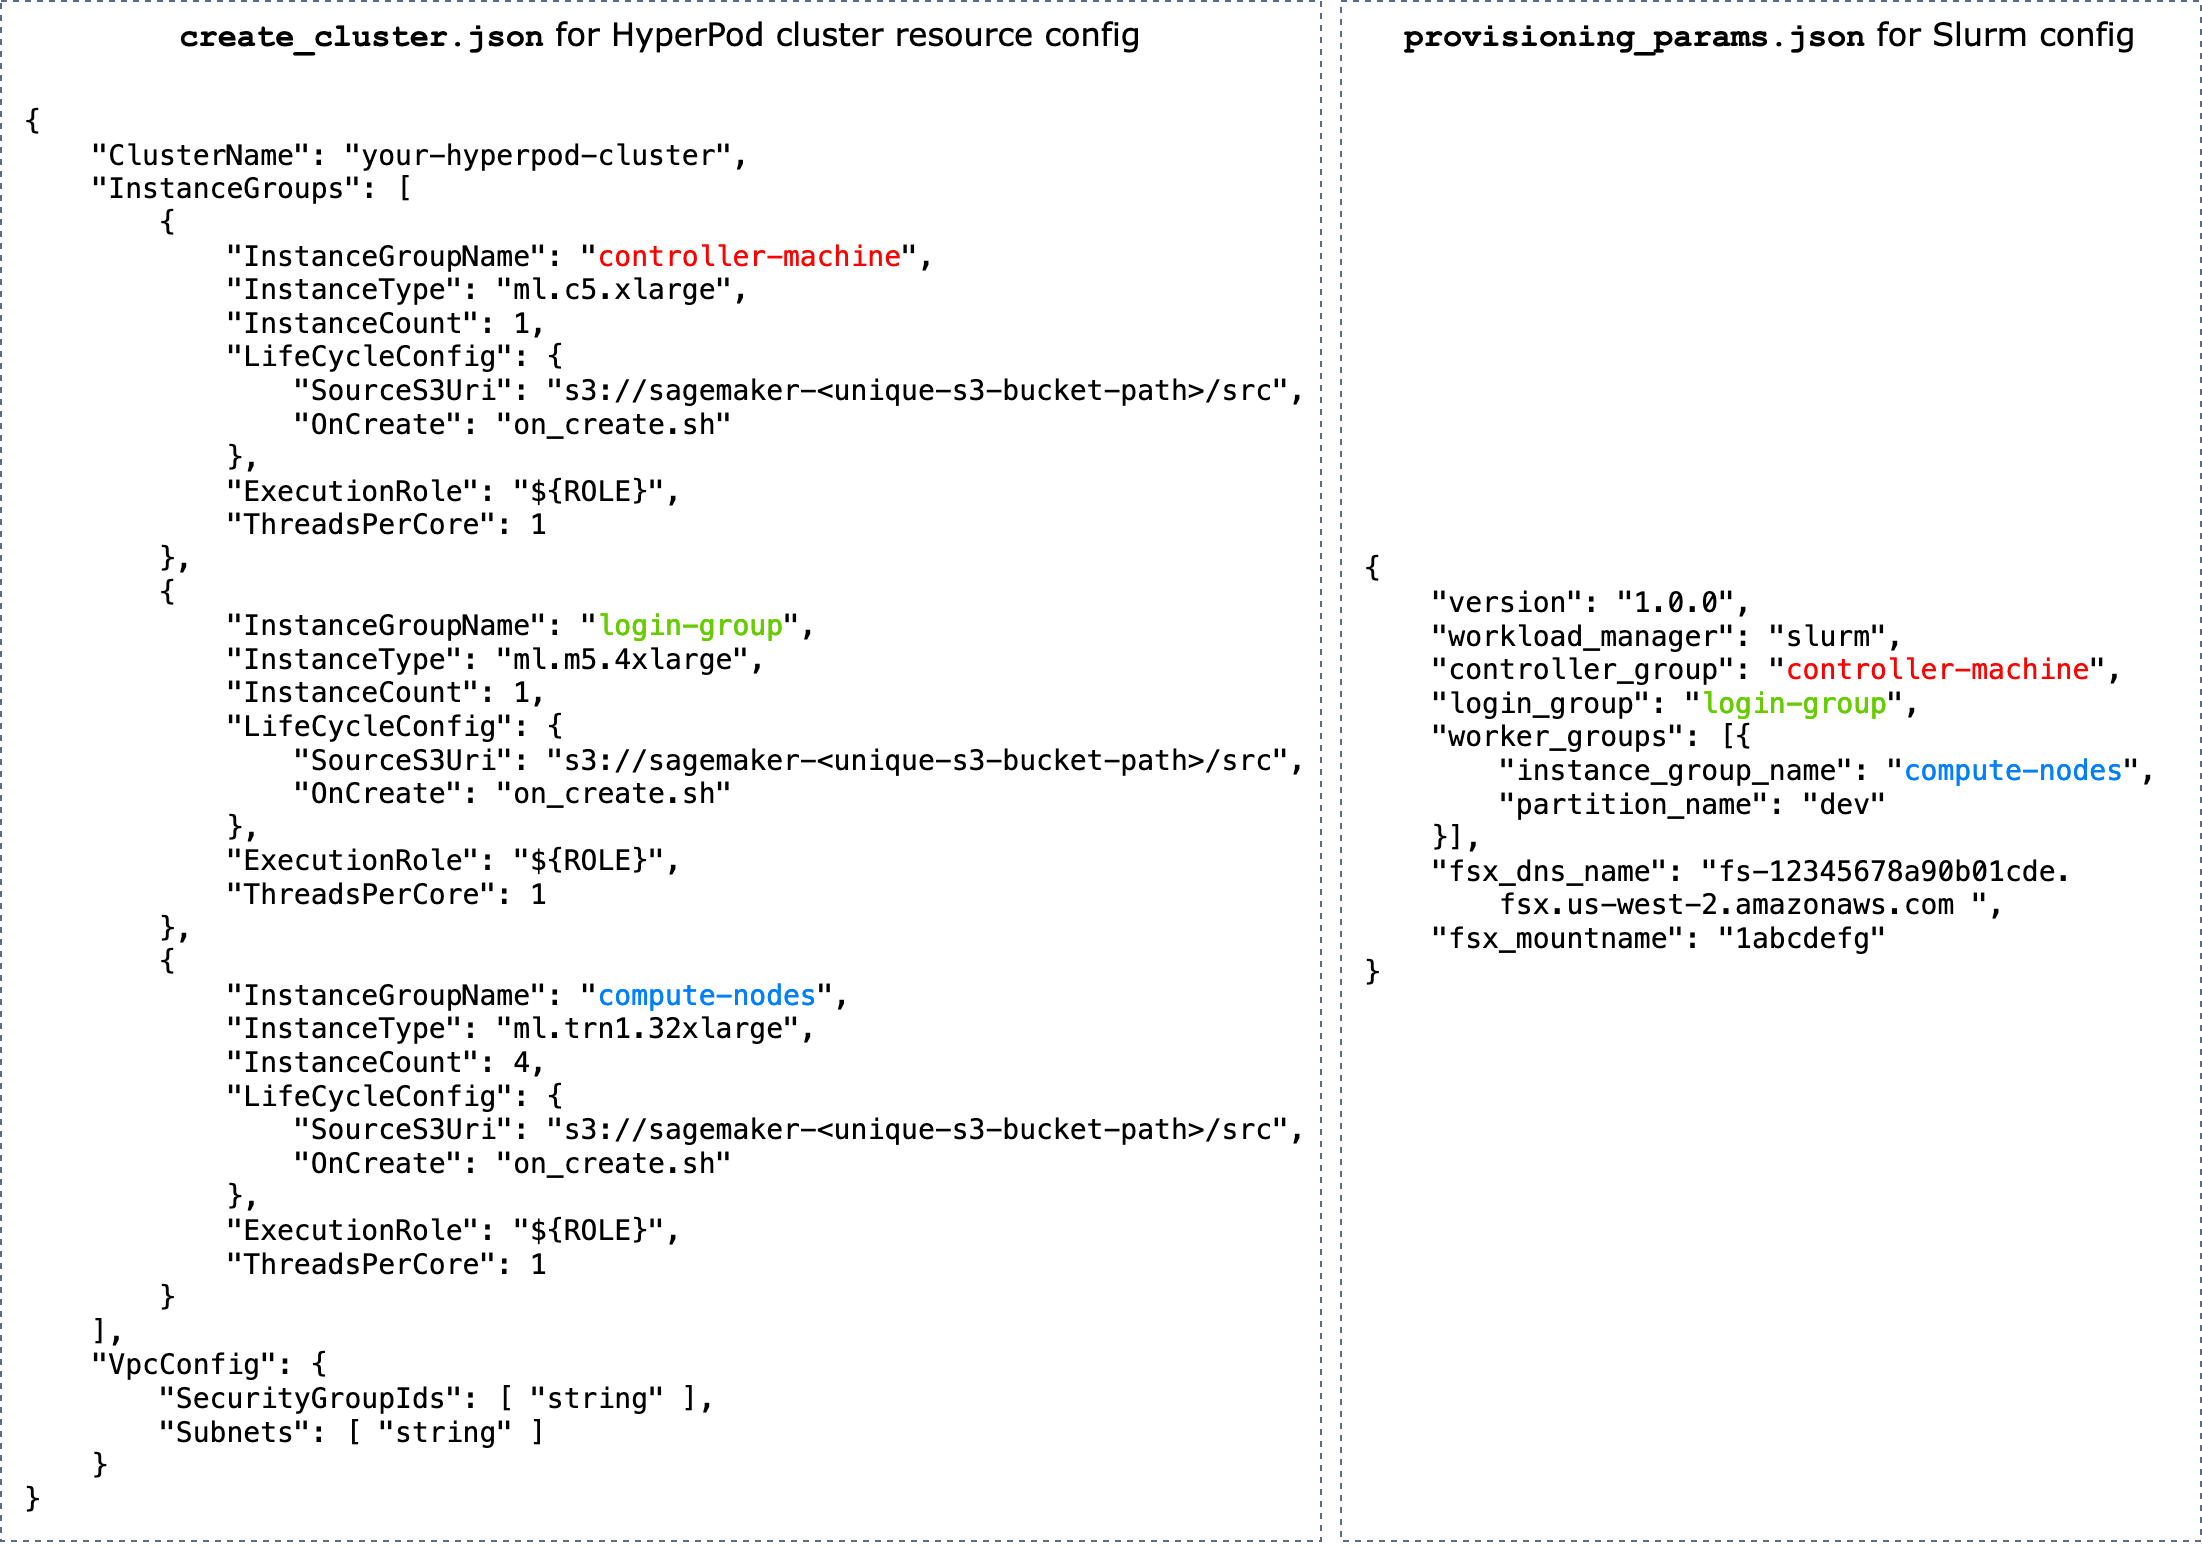
Abbildung: Direkter Vergleich zwischen
create_cluster.jsonder HyperPod Cluster-Erstellung undprovisiong_params.jsonder Slurm-Konfiguration. Die Anzahl der Instance-Gruppen increate_cluster.jsonsollte der Anzahl der Knoten entsprechen, die Sie als Slurm-Knoten konfigurieren möchten. Im Beispiel in der Abbildung werden drei Slurm-Knoten in einem HyperPod Cluster von drei Instanzgruppen konfiguriert. Sie sollten die HyperPod Cluster-Instanzgruppen Slurm-Knoten zuweisen, indem Sie die Instanzgruppennamen entsprechend angeben. -
resource_config.json— Während der Cluster-Erstellung wird daslifecycle_script.pySkript so geschrieben, dass es eineresource_config.jsonDatei von erwartet HyperPod. Diese Datei enthält Informationen über den Cluster, z. B. Instance-Typen und IP-Adressen.Wenn Sie die
CreateClusterAPI ausführen, HyperPod erstellt es eine Ressourcenkonfigurationsdatei unter, die auf dercreate_cluster.jsonDatei/opt/ml/config/resource_config.jsonbasiert. Der Dateipfad wird in der Umgebungsvariablen namensSAGEMAKER_RESOURCE_CONFIG_PATHgespeichert.Wichtig
Die
resource_config.jsonDatei wird automatisch von der HyperPod Plattform generiert und Sie müssen sie NICHT erstellen. Der folgende Code zeigt ein Beispiel fürresource_config.json, die aus der Clustererstellung basierend aufcreate_cluster.jsonim vorherigen Schritt erstellt würde, und soll Ihnen helfen zu verstehen, was im Backend geschieht und wie eine automatisch generierteresource_config.jsonaussehen würde.{ "ClusterConfig": { "ClusterArn": "arn:aws:sagemaker:us-west-2:111122223333:cluster/abcde01234yz", "ClusterName": "your-hyperpod-cluster" }, "InstanceGroups": [ { "Name": "controller-machine", "InstanceType": "ml.c5.xlarge", "Instances": [ { "InstanceName": "controller-machine-1", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" } ] }, { "Name": "login-group", "InstanceType": "ml.m5.xlarge", "Instances": [ { "InstanceName": "login-group-1", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" } ] }, { "Name": "compute-nodes", "InstanceType": "ml.trn1.32xlarge", "Instances": [ { "InstanceName": "compute-nodes-1", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" }, { "InstanceName": "compute-nodes-2", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" }, { "InstanceName": "compute-nodes-3", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" }, { "InstanceName": "compute-nodes-4", "AgentIpAddress": "111.222.333.444", "CustomerIpAddress": "111.222.333.444", "InstanceId": "i-12345abcedfg67890" } ] } ] } -
lifecycle_script.py— Dies ist das wichtigste Python-Skript, das gemeinsam Lifecycle-Skripte ausführt und Slurm während der Bereitstellung auf dem HyperPod Cluster einrichtet. Dieses Skript liest inprovisioning_parameters.jsonundresource_config.jsonaus den inon_create.shangegebenen oder identifizierten Pfaden, übergibt die relevanten Informationen an jedes Lebenszyklusskript und führt dann die Lebenszyklusskripte der Reihe nach aus.Lebenszyklusskripte sind eine Reihe von Skripten, die Sie vollständig flexibel anpassen können, um Softwarepakete zu installieren und während der Clustererstellung notwendige oder benutzerdefinierte Konfigurationen vorzunehmen, z. B. Slurm einrichten, Benutzer anlegen, Conda oder Docker installieren. Das Beispiel-Skript
lifecycle_script.pyist darauf vorbereitet, andere Basis-Lebenszyklusskripte im Repository auszuführen, z. B. Slurm-Daemons ( start_slurm.sh) zu starten, Amazon FSx für Lustre ( mount_fsx.sh) zu mounten und MariaDB-Abrechnung ( setup_mariadb_accounting.sh) sowie RDS-Abrechnung ( setup_rds_accounting.sh) einzurichten. Sie können auch weitere Skripte hinzufügen, sie in dasselbe Verzeichnis packen und Codezeilen hinzufügen, damit lifecycle_script.pydie Skripte HyperPod ausgeführt werden können. Weitere Informationen zu den grundlegenden Lifecycle-Skripten finden Sie auch unter 3.1 Lifecycle-Skriptsim Awsome Distributed Training GitHub Repository. Anmerkung
HyperPod wird SageMaker HyperPod DLAMI auf jeder Instanz eines Clusters ausgeführt, und das AMI verfügt über vorinstallierte Softwarepakete, die den Kompatibilitäten zwischen ihnen und den Funktionen entsprechen. HyperPod Beachten Sie, dass Sie für die Installation kompatibler Pakete verantwortlich sind, wenn Sie eines der vorinstallierten Pakete erneut installieren. Beachten Sie, dass einige HyperPod Funktionen möglicherweise nicht wie erwartet funktionieren.
Zusätzlich zu den Standardeinstellungen sind weitere Skripte zur Installation der folgenden Software im
utils-Ordner verfügbar. Die lifecycle_script.py-Datei enthält bereits Codezeilen zum Ausführen der Installationsskripte. Suchen Sie diese Zeilen anhand der folgenden Angaben und entfernen Sie die Kommentare, um sie zu aktivieren.-
Die folgenden Codezeilen beziehen sich auf die Installation von Docker
, Enroot und Pyxis . Diese Pakete sind erforderlich, um Docker-Container auf einem Slurm-Cluster auszuführen. Um diesen Installationsschritt zu aktivieren, legen Sie den
enable_docker_enroot_pyxis-Parameter in derconfig.py-Datei auf Truefest.# Install Docker/Enroot/Pyxis if Config.enable_docker_enroot_pyxis: ExecuteBashScript("./utils/install_docker.sh").run() ExecuteBashScript("./utils/install_enroot_pyxis.sh").run(node_type) -
Sie können Ihren HyperPod Cluster mit Amazon Managed Service for Prometheus und Amazon Managed Grafana integrieren, um Metriken über den HyperPod Cluster und die Clusterknoten in Amazon Managed Grafana-Dashboards zu exportieren. Um Metriken zu exportieren und das Slurm-Dashboard
, das Dashboard von NVIDIA DCGM Exporter und das EFA-Metrics-Dashboard auf Amazon Managed Grafana zu verwenden, müssen Sie den Slurm-Exporter für Prometheus , den NVIDIA-DCGM-Exporter und den EFA-Knoten-Exporter installieren. Weitere Informationen zur Installation der Exportpakete und zur Verwendung von Grafana-Dashboards in einem Workspace von Amazon Managed Grafana finden Sie unter SageMaker HyperPod Überwachung der Cluster-Ressourcen. Um diesen Installationsschritt zu aktivieren, legen Sie den
enable_observability-Parameter in derconfig.py-Datei auf Truefest.# Install metric exporting software and Prometheus for observability if Config.enable_observability: if node_type == SlurmNodeType.COMPUTE_NODE: ExecuteBashScript("./utils/install_docker.sh").run() ExecuteBashScript("./utils/install_dcgm_exporter.sh").run() ExecuteBashScript("./utils/install_efa_node_exporter.sh").run() if node_type == SlurmNodeType.HEAD_NODE: wait_for_scontrol() ExecuteBashScript("./utils/install_docker.sh").run() ExecuteBashScript("./utils/install_slurm_exporter.sh").run() ExecuteBashScript("./utils/install_prometheus.sh").run()
-
-
-
Stellen Sie sicher, dass Sie alle Konfigurationsdateien und Einrichtungsskripte aus Schritt 2 in den S3-Bucket hochladen, den Sie in der
CreateCluster-Anforderung in Schritt 1 angegeben haben. Nehmen wir beispielsweise an, dass Ihrecreate_cluster.jsonFolgendes enthält."LifeCycleConfig": { "SourceS3URI": "s3://sagemaker-hyperpod-lifecycle/src", "OnCreate": "on_create.sh" }Dann sollte ihr
on_create.sh,lifecycle_script.py,provisioning_parameters.jsonund alle anderen Einrichtungsskripte enthalten. Angenommen, Sie haben die Dateien wie folgt in einem lokalen Ordner vorbereitet.└── lifecycle_files // your local folder ├── provisioning_parameters.json ├── on_create.sh ├── lifecycle_script.py └── ... // more setup scrips to be fed into lifecycle_script.pyVerwenden Sie den S3-Befehl wie folgt, um die Dateien hochzuladen.
aws s3 cp --recursive./lifecycle_scriptss3://sagemaker-hyperpod-lifecycle/src
