Die vorliegende Übersetzung wurde maschinell erstellt. Im Falle eines Konflikts oder eines Widerspruchs zwischen dieser übersetzten Fassung und der englischen Fassung (einschließlich infolge von Verzögerungen bei der Übersetzung) ist die englische Fassung maßgeblich.
Streaming-Tabellen und S3-Bereitstellung für Amazon Kinesis Data Streams
Mit Amazon Kinesis Data Streams können Sie Streaming-Daten aus Ihren Kinesis-Datenströmen an zwei Zieltypen bereitstellen: Streaming-Tabellen auf Apache Iceberg (Amazon S3 S3-Tabellen) oder Amazon S3 S3-Buckets für allgemeine Zwecke. Sie müssen keine Infrastruktur verwalten und können innerhalb von Minuten mit der Bereitstellung beginnen. Amazon Kinesis Data Streams liest aus Ihrem Stream, puffert und aggregiert Datensätze und übermittelt sie an Ihr konfiguriertes Ziel. Die Lieferung erfolgt vollständig verwaltet — es müssen keine Konnektoren, Verbraucheranwendungen oder Rechenressourcen bereitgestellt werden.
Diese Funktionen werden für Streams unterstützt, die im On-Demand Advantage- oder On-Demand Standard-Kapazitätsmodus ausgeführt werden. Sie konfigurieren die Übertragung über Ihren Stream und geben ein Ziel an. Amazon Kinesis Data Streams kümmert sich dann automatisch um Skalierung, Wiederholungsversuche und Lieferzuverlässigkeit. Die Bereitstellung verbraucht nicht den Lesedurchsatz Ihres Streams und hat keine Auswirkungen auf bestehende Verbraucher.
Themen
Wie funktioniert die Datenzustellung
Die Datenzustellung verbindet Ihren Kinesis-Datenstrom über eine verwaltete Pipeline mit einem Lieferziel:
Sie veröffentlichen Daten in einem Kinesis-Datenstream im On-Demand Modus.
Sie rufen den Stream
CreateChannelauf und geben ein Ziel an (Streaming-Tabellen auf Apache Iceberg oder einen Amazon S3 S3-Bucket für allgemeine Zwecke).Die Lieferung liest aus dem Stream, puffert Datensätze und fasst sie zu Dateien mit optimaler Größe zusammen.
Bei der Lieferung werden die Dateien innerhalb des von Ihnen angegebenen Datenaktualisierungsfensters an Ihr konfiguriertes Ziel geschrieben.
Ziele für die Lieferung
Die Datenübermittlung unterstützt zwei Zieltypen:
- Streaming-Tabellen auf Apache Iceberg
-
Streaming-Tabellen liefern Ihren Kinesis-Datenstrom kontinuierlich in Apache Iceberg-Tabellen, die in Amazon S3 S3-Tabellen gespeichert sind. Sobald Daten eintreffen, werden sie automatisch in das optimierte Apache Parquet-Format mit intelligenter Inline-Komprimierung konvertiert, wodurch das Problem kleiner Dateien vermieden und die Kosten für nachgelagerte Abfragen reduziert werden. Innerhalb weniger Minuten nach der Veröffentlichung in Ihrem Stream können Daten über Amazon Athena, Amazon EMR, Amazon Managed Service for Apache Flink oder jede Engine, die Apache Iceberg unterstützt, abgefragt werden.
- Amazon S3 S3-Buckets für allgemeine Zwecke
-
Amazon S3 Delivery schreibt Streaming-Daten aus Ihrem Kinesis-Datenstream direkt in einen S3-Bucket. Datensätze werden in ihrem ursprünglichen Quellformat geliefert, ohne dass eine Transformation angewendet wird. Mehrere Datensätze werden gepuffert und zu Objekten mit optimaler Größe gebündelt. Dabei stehen konfigurierbare Komprimierung und eine S3-Schlüsselstruktur zur Verfügung, die Sie über die Ausgabeschlüsselvorlage definieren. Dies ist ideal für Anwendungsfälle wie die Archivierung von Rohprotokollen, die Wiedergabe von Ereignissen und die nachgelagerte Stapelverarbeitung, bei denen Sie eine dauerhafte, kostengünstige Speicherung Ihrer Streaming-Daten benötigen, ohne den Aufwand für die Verwaltung einer Lieferpipeline zu haben.
Datenfluss
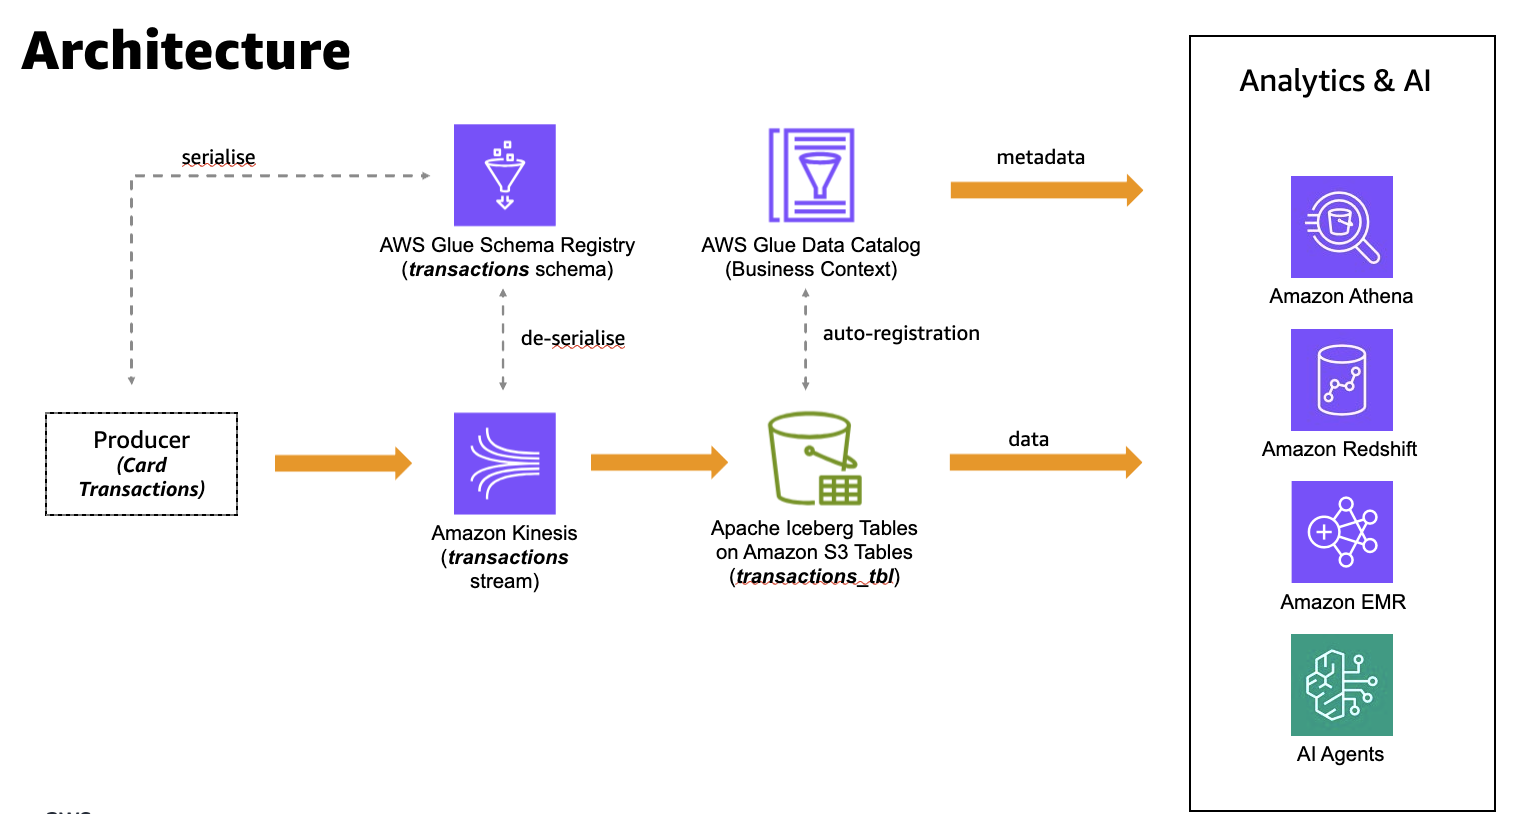
Das folgende Diagramm zeigt einen durchgängigen Datenfluss für die Bereitstellung an Streaming-Tabellen auf Apache Iceberg. Das Diagramm verwendet einen Anwendungsfall für Kartentransaktionen als Beispiel. Ein Producer serialisiert Datensätze anhand eines Schemas in AWS Glue Schema Registry und schreibt sie in einen Kinesis-Datenstream. Amazon Kinesis Data Streams liefert die Datensätze an Apache Iceberg-Tabellen auf Amazon S3 S3-Tabellen. Wenn Sie die Analyseintegration in S3-Tabellen aktivieren, werden die Tabellenmetadaten auch im AWS Glue Datenkatalog registriert. Dies ist standardmäßig nicht der Fall. Die bereitgestellten Daten und ihre Metadaten stehen dann Analyse- und KI-Engines wie Amazon Athena, Amazon Redshift und Amazon EMR zur Verfügung.
Die Lieferung an Amazon S3 S3-Buckets für allgemeine Zwecke erfolgt nach einem ähnlichen Ablauf, mit zwei Unterschieden. Ein Producer schreibt Datensätze in einen Kinesis-Datenstream, und Amazon Kinesis Data Streams liefert sie an Ihren S3-Bucket. Datensätze werden in ihrem ursprünglichen Quellformat ohne Konvertierung geliefert, sodass keine AWS Glue Schemaregistrierung erforderlich ist und keine Tabellenmetadaten im AWS Glue Datenkatalog registriert sind. Amazon Kinesis Data Streams puffert und stapelt Datensätze in Objekten mit optimaler Größe und schreibt sie unter Verwendung der S3-Schlüsselstruktur, die Sie über die Ausgabeschlüsselvorlage definieren. Die gelieferten Objekte stehen dann für die nachfolgende Stapelverarbeitung und Analyse zur Verfügung.
Die wichtigsten Funktionen
Die Datenbereitstellung bietet die folgenden wichtigen Funktionen:
Serverlose auto-scaling — Skaliert automatisch mit Ihrem Stream-Durchsatz bis zur Durchsatzkapazität des Streams. Es müssen keine Rechenressourcen bereitgestellt werden.
Exactly-once Lieferung pro Shard — Datensätze aus einem Shard werden genau einmal an das Ziel geliefert, ohne dass der Shard Duplikate oder Lücken enthält.
Lieferung nahezu in Echtzeit — Konfigurierbare Datenaktualität von 5 bis 15 Minuten (300 bis 900 Sekunden).
Automatische Parquet-Konvertierung — Konvertiert Streaming-Datensätze für Streaming-Tabellen auf Apache Iceberg in das optimierte Apache Parquet-Format für effiziente Analyseabfragen.
Inline-Komprimierung — Aggregiert Datensätze in Dateien mit optimaler Größe, um die Leistung von Analyseabfragen zu verbessern.
Verschlüsselung — Unterstützt vom Kunden verwaltete AWS KMS Schlüssel für die serverseitige Verschlüsselung am Zielort. Der Von AWS verwalteter Schlüssel (der
aws/kinesisAlias) wird für die Zielverschlüsselung nicht unterstützt.Dead-letter Warteschlange — Fehlermetadaten für Datensätze, die nicht zugestellt werden können — einschließlich Stream-ARN, Shard-ID, Sequenznummer und Fehlerkontext — werden in eine Warteschlange mit unlesbaren S3-based Buchstaben geschrieben.
CloudWatch Metriken und Protokolle — Überwachen Sie die gelieferten Bytes, die Anzahl der Datensätze und die Aktualität der Daten anhand von CloudWatch Amazon-Metriken. Aktivieren Sie die Versandprotokollierung in Amazon CloudWatch Logs, um Details zum Lieferstapel, Fehler und den Fehlerkontext für die Fehlerbehebung zu erfassen.
Keine Auswirkungen auf andere Verbraucher — Nutzt keine erweiterten Fan-Out-Slots und keinen gemeinsamen Durchsatz.
Voraussetzungen
Für die Datenübermittlung gelten die folgenden Anforderungen:
Ihr Kinesis-Datenstream muss den On-Demand Standard- oder On-Demand Advantage-Kapazitätsmodus verwenden.
Sie müssen eine IAM-Dienstausführungsrolle erstellen, die der Bereitstellung Schreibberechtigungen für Ihr Ziel gewährt.
Ihr Ziel-Bucket oder Tabellen-Bucket muss sich in derselben Region wie Ihr Kinesis-Datenstream befinden. Die Datenübermittlung unterstützt für keinen der Zieltypen eine regionsübergreifende Zustellung.
Für Streaming-Tabellen auf Apache Iceberg wird die kontoübergreifende Übermittlung nicht unterstützt. Der Quellstream, der Ziel-S3-Tabellen-Bucket und die AWS Glue Schemaregistrierung müssen sich alle in derselben AWS-Konto Region befinden.
Für allgemeine Amazon S3 S3-Buckets wird die kontoübergreifende Lieferung nur für den Ziel-Bucket unterstützt. Der Kanal und sein Quellstream müssen sich im selben System befinden. Nur AWS-Konto der Ziel-Bucket kann sich in einem anderen Konto befinden.
Für Streaming-Tabellen auf Apache Iceberg müssen Sie in Amazon S3 eine Warteschlange für unlesbare Briefe konfigurieren.
