Las traducciones son generadas a través de traducción automática. En caso de conflicto entre la traducción y la version original de inglés, prevalecerá la version en inglés.
Tablas de streaming y entrega en S3 para Amazon Kinesis Data Streams
Con Amazon Kinesis Data Streams, puede entregar datos de streaming desde sus transmisiones de datos de Kinesis a dos tipos de destinos: tablas de streaming en Apache Iceberg (tablas de Amazon S3) o buckets de Amazon S3 de uso general. No necesita administrar ninguna infraestructura y puede empezar a realizar entregas en cuestión de minutos. Amazon Kinesis Data Streams lee los datos de la transmisión, almacena en búfer y agrega los registros y los entrega al destino que haya configurado. La entrega está totalmente gestionada: no hay conectores, aplicaciones de consumo ni recursos de cómputo que aprovisionar.
Estas capacidades son compatibles con las transmisiones que se ejecutan en los modos de capacidad On-Demand Advantage o On-Demand Estándar. Puede configurar la entrega desde su transmisión y especificar un destino. A continuación, Amazon Kinesis Data Streams gestiona automáticamente el escalado, los reintentos y la fiabilidad de la entrega. La entrega no consume el rendimiento de lectura de la transmisión y no afecta a los consumidores actuales.
Temas
¿Cómo funciona la entrega de datos
La entrega de datos conecta la transmisión de datos de Kinesis con un destino de entrega a través de una canalización gestionada:
Los datos se publican en una transmisión de datos de Kinesis en On-Demand modo.
Llamas a
CreateChannella transmisión y especificas un destino (tablas de streaming en Apache Iceberg o un bucket de Amazon S3 de uso general).La entrega lee la transmisión, almacena los registros en un búfer y los agrega en archivos de tamaño óptimo.
La entrega graba los archivos en el destino configurado dentro de la ventana de actualización de datos que especifique.
Destinos de entrega
La entrega de datos admite dos tipos de destinos:
- Tablas de streaming en Apache Iceberg
-
Las tablas de streaming envían de forma continua la transmisión de datos de Kinesis a las tablas de Apache Iceberg almacenadas en Amazon S3 Tables. A medida que llegan los datos, se convierten automáticamente al formato optimizado de Apache Parquet con una compactación inteligente en línea que elimina el problema de los archivos pequeños y reduce los costos de las consultas posteriores. A los pocos minutos de publicarse en la transmisión, los datos se pueden consultar a través de Amazon Athena, Amazon EMR, Amazon Managed Service for Apache Flink o cualquier motor compatible con Apache Iceberg.
- Buckets de Amazon S3 de uso general
-
Amazon S3 Delivery graba los datos de streaming de su transmisión de datos de Kinesis directamente en un bucket de S3. Los registros se entregan en su formato de origen original sin aplicar ninguna transformación. Varios registros se almacenan en búfer y se agrupan en objetos de tamaño óptimo, con una compresión configurable y una estructura de claves S3 que se define a través de la plantilla de claves de salida. Esto resulta ideal para casos de uso como el archivado de registros sin procesar, la reproducción de eventos y el procesamiento por lotes posterior, en los que se necesita un almacenamiento duradero y económico de los datos de streaming sin la sobrecarga que supone gestionar un proceso de entrega.
Flujo de datos
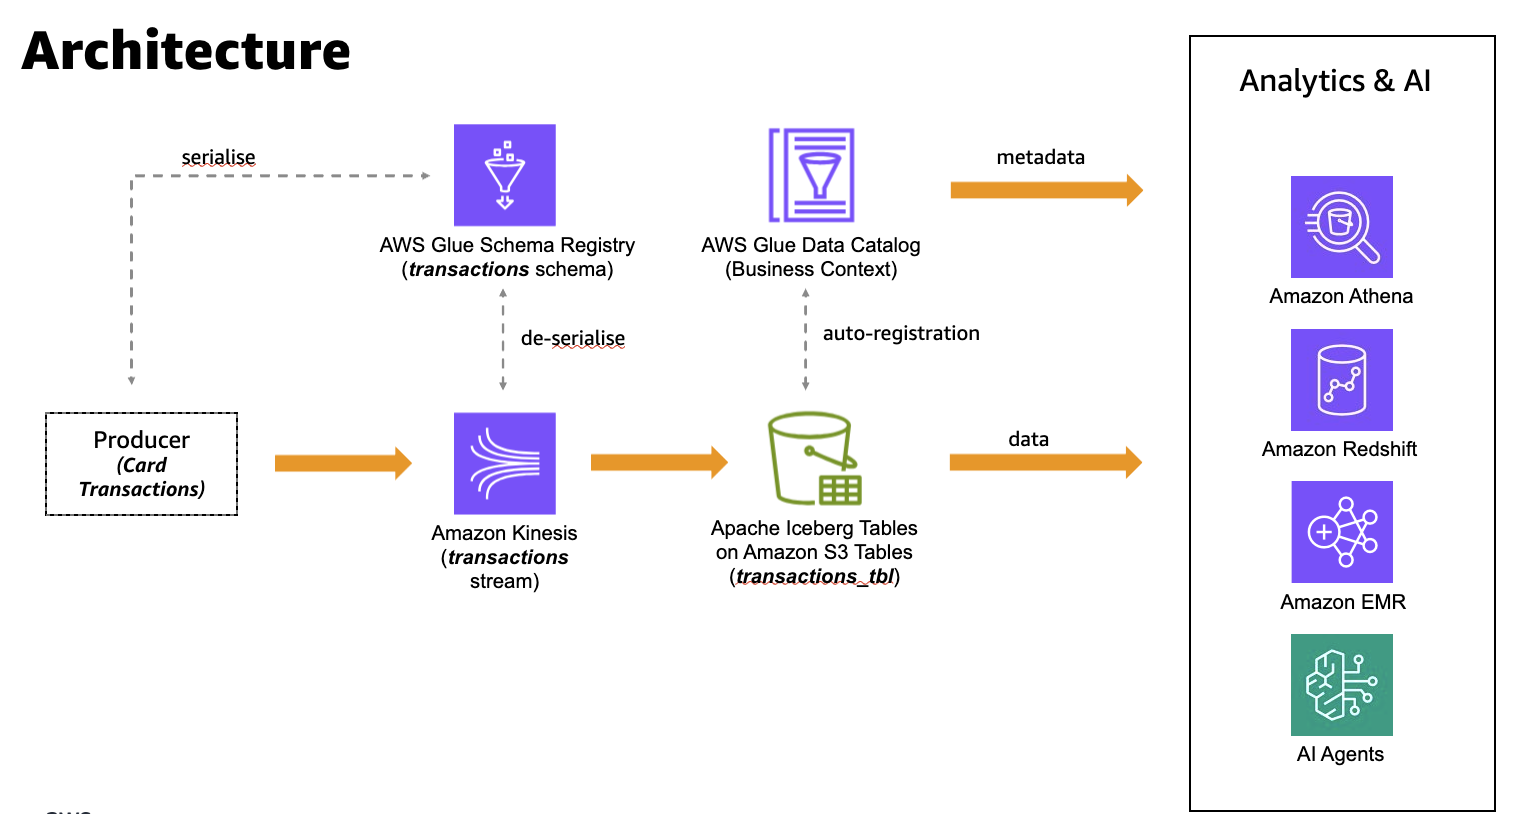
El siguiente diagrama muestra un flujo de datos integral para su entrega a las tablas de streaming en Apache Iceberg. El diagrama usa como ejemplo un caso de uso de transacciones con tarjetas. Un productor serializa los registros según un esquema de Schema Registry y los escribe en una transmisión de AWS Glue datos de Kinesis. Amazon Kinesis Data Streams entrega los registros a las tablas de Apache Iceberg de Amazon S3 Tables. Si habilita la integración de análisis en las tablas de S3, los metadatos de la tabla también se registran en el catálogo de AWS Glue datos; esto no ocurre de forma predeterminada. Los datos proporcionados y sus metadatos están entonces disponibles para los motores de análisis e inteligencia artificial, como Amazon Athena, Amazon Redshift y Amazon EMR.
La entrega a buckets de Amazon S3 de uso general sigue un flujo similar, con dos diferencias. Un productor escribe registros en una transmisión de datos de Kinesis y Amazon Kinesis Data Streams los envía a su bucket de S3. Los registros se entregan en su formato de origen original sin conversión, por lo que no es necesario registrar AWS Glue esquemas ni registrar metadatos de tablas en el catálogo de AWS Glue datos. Amazon Kinesis Data Streams almacena en búfer y agrupa los registros en objetos de tamaño óptimo y los escribe mediante la estructura de claves de S3 que se define a través de la plantilla de claves de salida. Los objetos entregados están entonces disponibles para su procesamiento y análisis por lotes posteriores.
Capacidades clave
La entrega de datos ofrece las siguientes funciones clave:
Autoscalamiento sin servidor: escala automáticamente en función del rendimiento de la transmisión, hasta alcanzar la capacidad de rendimiento de la transmisión. No hay que aprovisionar recursos de cómputo.
Exactly-once entrega por fragmento: los registros de un fragmento se entregan al destino exactamente una vez, sin duplicados ni omisiones en el fragmento.
Entrega casi en tiempo real: actualización de los datos configurable de 5 a 15 minutos (300 a 900 segundos).
Conversión automática de Parquet: en el caso de las tablas de streaming en Apache Iceberg, convierte los registros de streaming a un formato Apache Parquet optimizado para facilitar las consultas de análisis.
Compactación en línea: agrega los registros en archivos de tamaño óptimo para el rendimiento de las consultas de análisis.
Cifrado: admite AWS KMS claves administradas por el cliente para el cifrado del lado del servidor en el destino. El Clave administrada de AWS (el
aws/kinesisalias) no es compatible con el cifrado de destino.Dead-letter cola: los metadatos de error de los registros que no se pueden entregar (incluidos el ARN de la transmisión, el ID del fragmento, el número de secuencia y el contexto del error) se escriben en una cola de letra muerta. S3-based
CloudWatch métricas y registros: monitorea los bytes entregados, los recuentos de registros y la actualización de los datos a través de CloudWatch las métricas de Amazon. Habilita el registro de entregas en Amazon CloudWatch Logs para capturar los detalles del lote de entrega, los errores y el contexto de errores para la resolución de problemas.
No afecta a otros consumidores: no consume ranuras de distribución mejoradas ni un rendimiento compartido.
Requisitos
La entrega de datos tiene los siguientes requisitos:
La transmisión de datos de Kinesis debe utilizar el modo de capacidad On-Demand Estándar o On-Demand Advantage.
Debe crear una función de ejecución del servicio de IAM que conceda los permisos de entrega para escribir en su destino.
El depósito de destino o el depósito de mesa debe estar en la misma región que la transmisión de datos de Kinesis. La entrega de datos no admite la entrega entre regiones para ninguno de los dos tipos de destino.
En el caso de las tablas de streaming en Apache Iceberg, no se admite la entrega entre cuentas. La transmisión de origen, el depósito de tablas de S3 de destino y el registro de AWS Glue esquemas deben estar todos en la misma Cuenta de AWS región.
En el caso de los buckets de Amazon S3 de uso general, solo se admite la entrega entre cuentas para el bucket de destino. El canal y su transmisión de origen deben estar en el mismo lugar Cuenta de AWS; solo el segmento de destino puede estar en una cuenta diferente.
Para las tablas de streaming en Apache Iceberg, debe configurar una cola de letra muerta en Amazon S3.
