Le traduzioni sono generate tramite traduzione automatica. In caso di conflitto tra il contenuto di una traduzione e la versione originale in Inglese, quest'ultima prevarrà.
Utilizzo di indici secondari globali per query di aggregazione materializzate in DynamoDB
Il mantenimento di aggregazioni quasi in tempo reale e parametri chiave oltre a dati in rapida evoluzione sta acquisendo sempre più valore per permettere alle aziende di prendere decisioni in maniera veloce. Ad esempio, una libreria musicale potrebbe voler mostrare i brani più scaricati quasi in tempo reale, oppure una piattaforma di e-commerce potrebbe dover mostrare i prodotti di tendenza per categoria.
Perché DynamoDB non supporta nativamente operazioni di aggregazione come SUM o COUNT per tutti gli articoli, il calcolo di questi valori in fase di lettura richiederebbe la scansione di un gran numero di elementi, operazione che potrebbe essere lenta e costosa. Invece, puoi precalcolo aggregazioni man mano che i dati cambiano e archivia i risultati come elementi regolari nella tabella. Questo modello è chiamato aggregazione materializzata.
Argomenti
Scenario di esempio e modelli di accesso
Considerate un'applicazione di libreria musicale con i seguenti requisiti:
L'applicazione registra i download di singoli brani ad alto volume (migliaia al secondo).
Gli utenti devono vedere i brani più scaricati per un determinato mese con una latenza di una cifra in millisecondi.
L'applicazione deve inoltre supportare domande come «le 10 migliori canzoni di questo mese» e «tutte le canzoni scaricate in un determinato mese».
Calcolare il conteggio dei download in fase di lettura mediante la scansione di tutti i record di download potrebbe essere costoso su questa scala. È invece possibile mantenere un conteggio corrente che si aggiorna a ogni download e archiviarlo in modo da supportare un'interrogazione efficiente.
Perché precalcolare le aggregazioni
Esistono diversi approcci al calcolo delle aggregazioni. La tabella seguente confronta le alternative più comuni e spiega perché l'aggregazione materializzata in DynamoDB è spesso la soluzione migliore per questo tipo di caso d'uso.
| Approccio | Compromessi | Quando utilizzarlo |
|---|---|---|
| Scansiona e conta in fase di lettura | Richiede la lettura di tutti i record di download per ogni richiesta. La latenza aumenta con il volume dei dati e consuma una notevole capacità di lettura. | Adatto solo per set di dati molto piccoli in cui la latenza non è un problema. |
| Archivio di aggregazione esterno (ad esempio, Amazon ElastiCache) | Aggiunge complessità operativa con un servizio separato da gestire. Richiede una logica di sincronizzazione tra DynamoDB e la cache. | Quando hai bisogno di letture inferiori al millisecondo o di una logica di aggregazione complessa che vada oltre i semplici conteggi. |
| Application-level aggregazione in scrittura | Associa la logica di aggregazione al percorso di scrittura. Se l'applicazione fallisce dopo aver registrato il download ma prima di aggiornare il conteggio, l'aggregazione diventa incoerente. | Quando è necessaria un'aggregazione sincrona e fortemente coerente e si può tollerare una maggiore latenza di scrittura. |
| Aggregazione materializzata con Streams e Lambda | Seaccoppia l'aggregazione dal percorso di scrittura. L'aggregazione alla fine è coerente (in genere con pochi secondi di ritardo). Aggiunge i costi di chiamata Lambda. | Quando hai bisogno di aggregazioni quasi in tempo reale con bassa latenza di lettura e puoi tollerare un'eventuale coerenza. Questo è l'approccio descritto in questa pagina. |
L'approccio di aggregazione materializzata mantiene semplice il percorso di scrittura (basta registrare il download), trasferisce l'aggregazione in un processo asincrono e memorizza il risultato in DynamoDB dove può essere interrogato con una latenza di una cifra in millisecondi.
Progettazione di tabelle
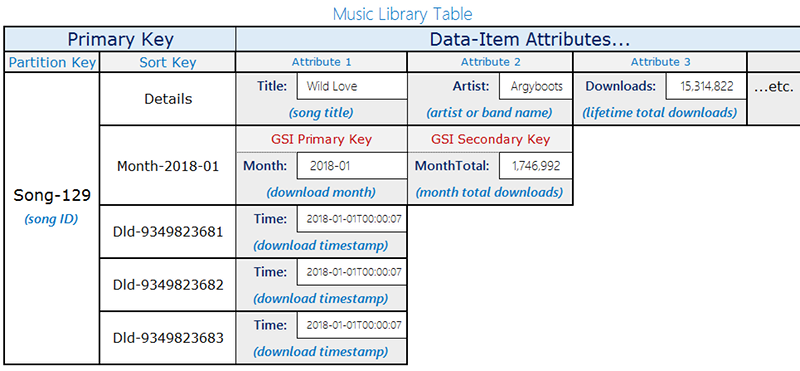
Questo design utilizza una singola tabella con due tipi di elementi che condividono la stessa chiave di partizione (songID) ma utilizza diversi modelli di chiavi di ordinamento per distinguerli:
Scarica i record — Eventi di download individuali. La chiave di ordinamento è
DownloadID(un identificatore univoco per ogni download).Elementi di aggregazione mensile — Pre-computed numero di download per brano al mese. La chiave di ordinamento è il mese in
YYYY-MMformato (ad esempio,2018-01). Questi articoli contengono anche unDownloadCountattributo con il totale progressivo.
Solo gli elementi di aggregazione mensile contengono Month attributo. Questa distinzione è importante per il design GSI sparso descritto più avanti.
Il diagramma seguente mostra il layout della tabella con entrambi i tipi di elementi:
| Tipo di elemento | Chiave di partizione (SongID) | Chiave di ordinamento | Attributi aggiuntivi |
|---|---|---|---|
| Scarica il record | song1 |
download-abc123 |
UserID, Timestamp |
| Aggregazione mensile | song1 |
2018-01 |
Month=2018-01,
DownloadCount=1,746,992 |
Pipeline di aggregazione con Streams e AWS Lambda
La pipeline di aggregazione funziona come segue:
Quando una canzone viene scaricata, l'applicazione scrive un nuovo elemento nella tabella con
Partition-Key=songIDeSort-Key=DownloadID.DynamoDB Streams acquisisce questa scrittura come record di flusso.
Una funzione Lambda, collegata allo stream, elabora il nuovo record. Identifica il
songIDe il mese corrente, quindi aggiorna l'elemento di aggregazione mensile corrispondente incrementando ilDownloadCountattributo.L'elemento di aggregazione aggiornato è quindi disponibile per l'interrogazione tramite il GSI sparso.
La funzione Lambda utilizza un UpdateItem chiama con un ADD espressione per incrementare atomicamente il numero di download. Ciò evita le condizioni di gara di lettura-modifica-scrittura:
import boto3

dynamodb = boto3.resource('dynamodb')
table = dynamodb.Table('MusicLibrary')

def handler(event, context):
    for record in event['Records']:
        if record['eventName'] == 'INSERT':
            new_image = record['dynamodb']['NewImage']
            song_id = new_image['songID']['S']
            # Derive the month from the download timestamp
            timestamp = new_image['Timestamp']['S']
            month = timestamp[:7]  # Extract YYYY-MM

            table.update_item(
                Key={
                    'songID': song_id,
                    'SK': month
                },
                UpdateExpression='ADD DownloadCount :inc SET #m = :month',
                ExpressionAttributeNames={
                    '#m': 'Month'
                },
                ExpressionAttributeValues={
                    ':inc': 1,
                    ':month': month
                }
            )
Se un'esecuzione Lambda fallisce dopo aver scritto il valore di aggregazione aggiornato, il record dello stream potrebbe essere ritentato. Perché ADD l'operazione incrementa il conteggio ogni volta che viene eseguita, un nuovo tentativo aumenterebbe il conteggio più di una volta per lo stesso download, lasciandoti con un approssimativa valore. Per la maggior parte dei casi di utilizzo delle analisi e delle classifiche, questo piccolo margine di errore è accettabile. Se hai bisogno di conteggi esatti, valuta la possibilità di aggiungere la logica dell'idempotenza, ad esempio utilizzando un'espressione condizionale che verifichi se quella specifica DownloadID è già stato elaborato.
Design GSI sparso
Per interrogare in modo efficiente i risultati aggregati, crea un indice secondario globale con il seguente schema chiave:
Chiave di partizione GSI:
Month(Stringa)Chiave di ordinamento GSI:
DownloadCount(Numero)
Questo GSI è radi perché solo gli elementi di aggregazione mensili contengono Month attributo. I singoli record di download non hanno questo attributo, quindi vengono automaticamente esclusi dall'indice. Ciò significa che il GSI contiene solo gli elementi di aggregazione precalcolati, una piccola parte degli elementi totali della tabella.
Un GSI sparso offre due vantaggi principali:
Costo inferiore — Poiché nell'indice vengono replicati solo gli elementi di aggregazione, si consuma molta meno capacità di scrittura e spazio di archiviazione rispetto a un indice che include tutti gli elementi della tabella.
Interrogazioni più veloci — L'indice contiene solo i dati necessari per l'interrogazione, quindi le letture sono efficienti e restituiscono risultati con una latenza di una cifra in millisecondi.
Per ulteriori informazioni sul funzionamento degli indici sparsi, vedere Trai vantaggio degli indici di tipo sparse.
Interrogazione del GSI
Con il GSI sparso, puoi rispondere in modo efficiente a diversi tipi di domande:
Ottieni la canzone più scaricata in un determinato mese:
aws dynamodb query \
    --table-name "MusicLibrary" \
    --index-name "MonthDownloadsIndex" \
    --key-condition-expression "#m = :month" \
    --expression-attribute-names '{"#m": "Month"}' \
    --expression-attribute-values '{":month": {"S": "2018-01"}}' \
    --scan-index-forward false \
    --limit 1
Impostazione ScanIndexForward a false ordina i risultati per DownloadCount in ordine decrescente e Limit=1 restituisce solo la canzone principale.
Ottieni le 10 migliori canzoni di un determinato mese:
aws dynamodb query \
    --table-name "MusicLibrary" \
    --index-name "MonthDownloadsIndex" \
    --key-condition-expression "#m = :month" \
    --expression-attribute-names '{"#m": "Month"}' \
    --expression-attribute-values '{":month": {"S": "2018-01"}}' \
    --scan-index-forward false \
    --limit 10
Scarica tutti i brani in un determinato mese (ordinati per numero di download):
aws dynamodb query \
    --table-name "MusicLibrary" \
    --index-name "MonthDownloadsIndex" \
    --key-condition-expression "#m = :month" \
    --expression-attribute-names '{"#m": "Month"}' \
    --expression-attribute-values '{":month": {"S": "2018-01"}}' \
    --scan-index-forward false
Considerazioni
Tieni presente quanto segue quando implementi questo modello:
Coerenza finale — I valori di aggregazione vengono aggiornati in modo asincrono tramite DynamoDB Streams e Lambda. In genere c'è un ritardo di alcuni secondi tra la registrazione di un download e l'aggiornamento dell'aggregazione. Ciò significa che il GSI riflette dati quasi in tempo reale, non dati in tempo reale.
Concorrenza Lambda — Se la tabella ha un volume di scrittura elevato, più chiamate Lambda potrebbero tentare di aggiornare contemporaneamente lo stesso elemento di aggregazione. L'atomico
ADDL'operazione lo gestisce in modo sicuro, ma dovresti monitorare le metriche di concorrenza e limitazione di Lambda per assicurarti che la tua funzione possa stare al passo con lo streaming.Capacità di scrittura GSI — Poiché il GSI sparso contiene solo elementi di aggregazione, richiede una capacità di scrittura significativamente inferiore rispetto alla tabella di base. Tuttavia, è comunque necessario fornire una capacità sufficiente (o utilizzare la modalità su richiesta) per gestire la frequenza degli aggiornamenti dell'aggregazione.
Conteggi approssimativi — Come notato in precedenza, i tentativi di Lambda possono causare un numero leggermente superiore al conteggio. Per i casi d'uso che richiedono conteggi esatti, implementa i controlli di idempotenza nella funzione Lambda.
